
Jev contra Clef no xadrez: 300 jogos, um pedido justo, muitos empates
Em setembro pus o Jev da TypeSafe num tabuleiro de Batalha Naval, e na semana passada passei o Clef da Cloudflare pelo mesmo benchmark. Das duas vezes, o resultado teve a mesma forma. Cada modelo empatou com código simples depois de o código lhe construir uma lista curta, e num tabuleiro em bruto todos ficaram muito atrás de umas poucas linhas de heurística.
A Batalha Naval tem um problema como benchmark para estes modelos: ninguém joga de volta. Os modelos nunca se enfrentaram, só enfrentaram uma frota parada. Por isso a pergunta seguinte era óbvia. O que acontece modelo contra modelo, num jogo em que o adversário castiga cada erro?
Construí o benchessmark, pus o Jev, o Clef e o Clef-flash a jogar 300 partidas de xadrez, e deixei o Stockfish avaliar cada jogada.
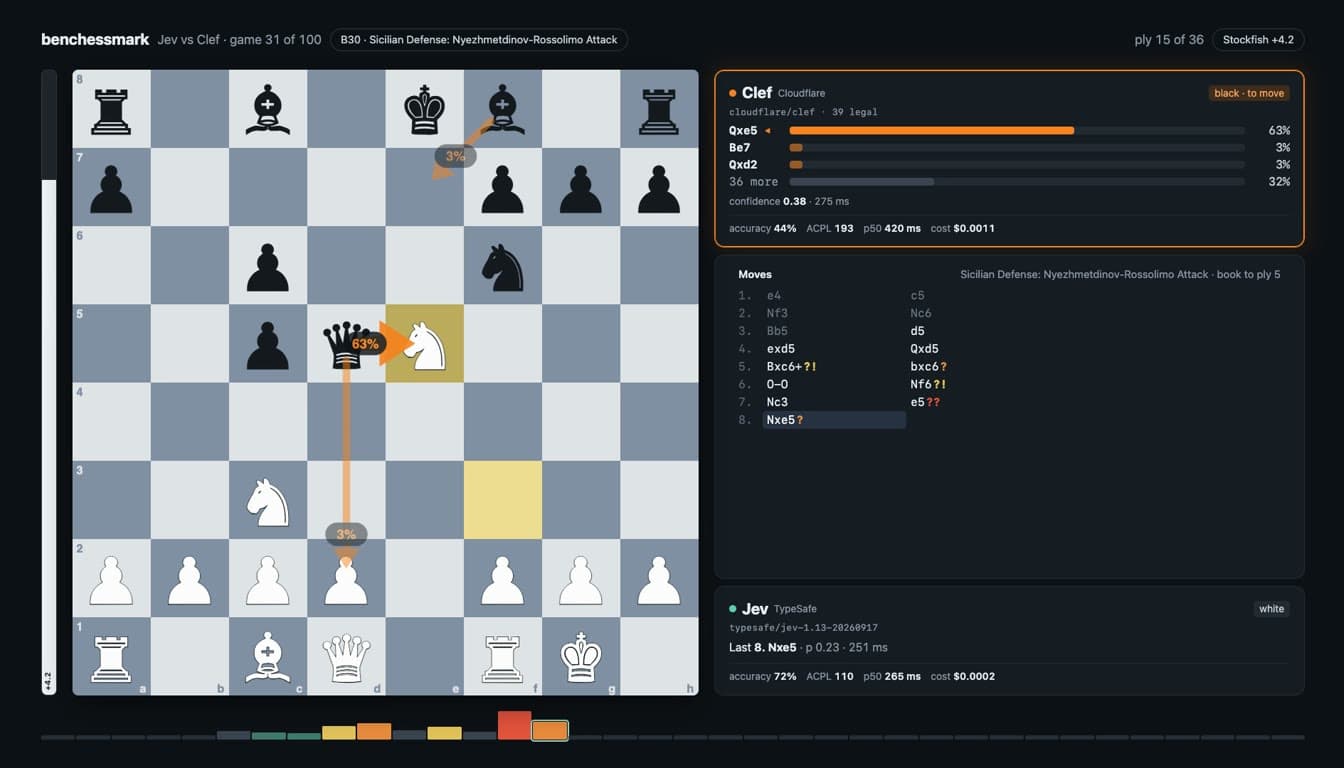
Jogo 31: o Jev (brancas) contra o Clef, gerado diretamente a partir do ficheiro do jogo. As setas são as três jogadas preferidas de cada modelo.
Dois modelos que não escrevem
Se não leste os artigos anteriores: o Jev e o Clef não são modelos de chat. Envias-lhes um estado e um conjunto de perguntas tipadas e, em vez de escreverem uma resposta, devolvem uma probabilidade para cada opção que permitiste. Uma passagem, sem texto. O Clef é o modelo de 27B, e o Clef-flash é o de 9B, feito para ser rápido.
Este formato é uma prenda para o xadrez. Em cada jogada faço uma pergunta ("Pick the best move for white in this position") e passo todas as jogadas legais como opções. O máximo de jogadas legais que uma posição de xadrez pode ter é 218, e as duas APIs aceitam até 255 opções por pergunta, por isso uma posição cabe sempre por inteiro. Também quer dizer que um modelo nunca consegue fazer uma jogada ilegal. Quem já viu um modelo de chat a tentar jogar xadrez sabe quanto tempo isto poupa.
Ser justo quando não há nada para afinar
O meu primeiro instinto foi alinhar as definições. O mesmo esforço, a mesma temperatura, tudo igual, para nenhum modelo partir com vantagem.
Não há nada para alinhar. Nenhuma das APIs tem uma definição de esforço, uma temperatura ou uma seed. O modelo lê o estado uma vez e responde.
Por isso a justiça tem de vir do código à volta. Os dois modelos passam pelo mesmo endpoint (a Decisions API do OpenRouter), por isso o caminho de rede é idêntico e o custo é faturado em vez de estimado. Os dois recebem o mesmo estado: o FEN, um tabuleiro em texto com cada casa escrita por extenso, e a lista de jogadas até ali. O tabuleiro em texto está lá porque a própria documentação da TypeSafe aponta contar como um ponto fraco do Jev, e uma fila de FEN como n2Pp1N1 tem de ser contada para ser lida.
Antes do primeiro jogo, o programa constrói o primeiro pedido de cada jogador e compara-os. Se alguma coisa além do id do modelo for diferente, o jogo nem começa. Mostra a comparação lado a lado, e acabou por ser o ecrã mais tranquilizador do projeto todo:
                      Jev               Clef
transport             openrouter        openrouter       ✓
question              #ee21d4           #ee21d4          ✓
pick                  top, seeded tie   top, seeded tie  ✓
effort, temp          none exist        none exist       ✓
first request         same except model #273b9f          ✓

Not settable
probability decimals  2                 4                !
build reported        resolved build    alias only       !
state read limit      32k tokens        ≈2k tokens       ✓
Esse último bloco é a parte que não consegui resolver, por isso mostro-a. O Jev arredonda as probabilidades a duas casas decimais e o Clef devolve quatro, algo que já tinha medido no projeto da Batalha Naval. O Jev diz exatamente que versão respondeu (jev-1.13-20260917) e o Clef só indica o alias. E a infraestrutura que serve o Clef lê mais ou menos os primeiros 2.000 tokens do estado. Um jogo longo neste formato tem cerca de 360 tokens, e cada jogada confirma que fica abaixo dos 1.500, por isso esse está resolvido.
A regra para transformar probabilidades numa jogada é a mesma para os dois: jogar a jogada legal mais provável, e desempatar com um sorteio com seed. Não uso o campo choice da própria API porque a forma como desempata não está documentada, e com as duas casas decimais do Jev há empates no topo em cerca de 5% das jogadas.
Cada confronto joga as mesmas 50 aberturas (com os nomes da lista de aberturas do lichess), uma vez com cada modelo de brancas. São 100 jogos por par. Depois o Stockfish 19 avalia cada jogada a profundidade 18, e a precisão usa a mesma fórmula que o lichess.
Os resultados
| confronto | resultado | diferença de Elo (intervalo de 95%) |
|---|---|---|
| Clef contra Jev | 57 a 43 | Clef +49 (+17 a +82) |
| Clef-flash contra Jev | 55,5 a 44,5 | Clef-flash +38 (+11 a +66) |
| Clef-flash contra Clef | 52 a 48 | +14 (−17 a +45), empate |
Os dois Clefs ganham ao Jev, e nenhum dos intervalos chega perto de zero. Um contra o outro, os dois Clefs são cara ou coroa: o Clef-flash fez um pouco mais de pontos, mas 100 jogos não chegam para os separar.
Jogada a jogada, as diferenças são menores do que os resultados fazem parecer. Contra o Jev, o Clef jogou com 63,5% de precisão contra os 58,5% do Jev, com uma perda média de 101 centipeões contra 106. Os dois fizeram cerca de 9 erros graves por cada 100 jogadas. Os dois encontraram a melhor jogada do Stockfish em menos de um terço das vezes. Se jogas xadrez, isto é um jogador de clube que joga logo sem calcular nada, que é mais ou menos o que um modelo de uma só passagem é.
Onde são mesmo diferentes: saber quando têm razão
Cada resposta vem com um valor de confiança, e é aqui que os modelos se separam.
Agrupei todas as jogadas pela confiança do modelo e vi quantas vezes jogou a jogada do Stockfish:
| confiança | Jev | Clef | Clef-flash |
|---|---|---|---|
| 0,0 a 0,2 | 19% | 21% | 22% |
| 0,4 a 0,6 | 52% | 75% | 74% |
| 0,6 a 0,8 | 65% | 85% | 93% |
| 0,8 a 1,0 | 100% (4 jogadas) | 98% (112 jogadas) | 100% (90 jogadas) |
Quando os Clefs têm a certeza, acertam quase sempre, e têm a certeza umas cem vezes por confronto. O Jev chegou a esse nível 4 vezes em 100 jogos. Com pouca confiança, os três são iguais.
Para quem constrói em cima destes modelos, esta tabela conta mais do que a diferença de Elo. A documentação da TypeSafe sugere agir acima de um limiar de confiança e escalar abaixo dele. Com o Clef, essa estratégia tem muito espaço para funcionar. Com o Jev, quase tudo fica abaixo da linha.
Velocidade e dinheiro
| Jev | Clef | Clef-flash | |
|---|---|---|---|
| latência mediana | 260 a 318 ms | 400 a 423 ms | 330 ms |
| custo por 100 jogos | $0,14 a $0,16 | $0,78 a $0,79 | $0,28 a $0,31 |
O Jev é o mais rápido e o mais barato, com folga. O Clef custa cerca de cinco vezes mais por jogo. O Clef-flash joga o mesmo xadrez que o Clef por cerca de um terço do preço, o que faz dele a escolha óbvia se só olhares para estes números.
Os três confrontos de 100 jogos custaram cerca de $2,50 ao todo. O benchmark inteiro, com as corridas de teste, ficou abaixo dos $3.
Tantos empates
Esta não esperava. Entre 76 e 83 jogos em cada 100 acabaram empatados, e quase todos por tripla repetição.
Faz sentido quando pensas em como estes modelos jogam. Não fazem planos. Veem a posição, pontuam as jogadas, e o programa joga a primeira. Numa posição calma, o modelo dá a mesma resposta sempre que vê essa posição, por isso as peças andam para trás e para a frente até a posição se repetir três vezes. A lista de jogadas vai em cada pedido, por isso em teoria os modelos podiam reparar. Nenhum reparou.
Podia fazer isto desaparecer sorteando a partir das probabilidades em vez de jogar sempre a primeira, mas isso muda a experiência. O arredondamento a duas casas do Jev põe muitas opções a exatamente zero, por isso sortear trataria os dois modelos de forma diferente. Prefiro mostrar os empates com honestidade do que escondê-los com uma definição que favorece um modelo sem ninguém dar por isso.
Ver os jogos
Queria ver os jogos, não só os números. O benchessmark tem um visualizador que mostra o tabuleiro, as três jogadas preferidas de cada modelo como setas com as probabilidades, a avaliação do Stockfish e a nota de cada jogada numa linha do tempo. Também consegue acompanhar um confronto ao vivo enquanto decorre.
Para gravar, a primeira ideia foi gravar o ecrã. Em vez disso, o visualizador tem um modo de gravação, e um script percorre-o fotograma a fotograma num browser sem interface e passa cada fotograma ao ffmpeg. O mesmo jogo dá sempre o mesmo vídeo, a qualquer velocidade, e um clip de 50 segundos fica pronto em pouco mais de um minuto.
O jogo no topo deste artigo é um bom exemplo de como estes modelos jogam. O Jev, de brancas, consegue uma vantagem clara numa Siciliana Rossolimo, devolve-a com 9. d4 e perde a dama na jogada seguinte. O Clef não hesita: fica com tudo o que lhe oferecem e dá mate na jogada 18 com Dxe1#. Repara nas setas e vês como raramente algum dos modelos tem certeza de alguma coisa até a posição ficar simples.
O que isto não nos diz
Aplicam-se as mesmas ressalvas que ponho em todos os benchmarks que escrevo.
Isto é uma configuração: uma pergunta, um formato de estado, a primeira jogada sempre jogada, sem olhar para a frente. Outro prompt ou outro estado podia ordenar os modelos de outra maneira. Não diz que o Clef é melhor do que o Jev em geral. Diz que o Clef joga melhor xadrez nesta configuração.
Não ordena o Clef e o Clef-flash. O intervalo deles inclui o zero.
Só cobre as versões que responderam. O Jev foi jev-1.13-20260917 em todas as chamadas. Os Clefs só indicam o alias, por isso uma atualização silenciosa durante estas corridas não aparecia em lado nenhum.
E mais corridas não ajudavam muito. Com a primeira jogada sempre jogada, repetir as mesmas aberturas muito provavelmente repetia os mesmos jogos. Mais evidência precisa de mais aberturas, não de mais repetições.
Experimenta
O código, os 300 jogos em PGN e o relatório completo dos resultados estão no GitHub. Juntar outro modelo System One é uma entrada num ficheiro de configuração, e o projeto traz dois jogadores feitos só com código (um que joga ao acaso e o Stockfish limitado a 1320 de Elo) para poderes pôr qualquer modelo novo na mesma escala.
Na Batalha Naval, todos os modelos precisaram que o código fizesse metade do trabalho para conseguirem acompanhar. No xadrez, ninguém fez o trabalho por eles, e os modelos jogaram como aquilo que são: rápidos, baratos, instintivos, e sem ideia do que vão fazer daqui a duas jogadas.